화웨이 어센드 960, 화웨이가 만드는 AI 가속기의 다음 세대입니다. 이 칩이 2027년 3분기가 아니라 1분기에 준비된다고 왕타오 순환회장 겸 대행회장이 9월 17일 상하이에서 열린 화웨이 커넥트 2026에서 밝혔습니다.
반도체 일정에서 세 분기는 큰 폭입니다. 화웨이 관계자는 테크크런치에 이 칩이 1분기에 준비될 것이며 어센드 960 계열이 일정보다 앞당겨 나오면서 성능은 두 배가 된다고 말했습니다.
다만 이날 발표의 중심은 칩이 아니었습니다. 같은 자리에서 화웨이는 피어리움(Peerium)이라는 이름의 새 컴퓨팅 구조를 공개했습니다. 프로세서 100만 개를 컴퓨터 한 대처럼 쓰게 하겠다는 것이 목표입니다.

천천히 읽어야 할 쪽은 두 번째 발표입니다. 칩이 빨라졌다는 소식은 해마다 나옵니다. 그 칩 100만 개를 어떻게 연결하느냐는 이야기는 화웨이가 어디를 진짜 한계로 보고 있는지를 드러냅니다.
화웨이 어센드 960, 앞당겨진 세 분기
지난해 공개된 로드맵은 어센드 950 계열을 2026년, 960을 2027년, 970을 2028년, 980을 2029년에 배치했습니다. 1년에 한 세대씩 올리는 주기이고 화웨이는 이 주기를 타오의 법칙(Tao Law)이라고 부릅니다.
950 계열 안에서도 두 제품은 하는 일이 다릅니다. 950PR은 추론의 앞단 처리와 추천 작업을 맡고, 950DT는 디코딩과 학습을 맡으면서 메모리 용량과 대역폭을 더 갖습니다.
2027년 1분기로 당겨진 제품은 960DT입니다. 중국 매체 관찰자망은 960PR이 같은 해 3분기에 이어 나오며 이 역시 원래 계획보다 한 분기 빠르다고 전했습니다.
화웨이는 960이 950보다 연산 성능을 대략 두 배로 올리고, 메모리 대역폭과 용량, 연결 대역폭도 함께 키운다고 설명했습니다. 공정 세대가 아니라 이 세 가지 수치로 각 단계를 설명한다는 점이 눈에 띕니다.
설명 방식이 그렇게 된 이유가 있습니다. 미국의 수출 통제로 화웨이가 쓸 수 있는 생산 공정이 제한돼 있어, 트랜지스터를 더 작게 만들어 얻던 이득을 시스템의 다른 곳에서 찾아야 합니다.
수요는 걸림돌이 아닙니다. 블룸버그는 딥시크가 네이멍구에 새로 짓는 데이터센터에 어센드 950DT를 최소 16만 장 넣을 계획이라고 보도했습니다. 화웨이는 말레이시아와 이집트에서도 고객을 찾고 있습니다.

화웨이 어센드 960, 칩을 하나로 묶는 연결 방식
피어리움은 화웨이가 분명하게 밝힌 세 가지 위에 서 있습니다. 중첩 병렬 처리, 여러 기계가 함께 쓰는 하나의 메모리 주소 공간, 그리고 주종 관계가 없는 대등 연결입니다.
달라진 지점은 세 번째입니다. 큰 기계는 수십 년 동안 중앙 프로세서가 작업을 나눠 주면 가속기가 받아 처리하는 방식이었습니다. 화웨이는 연산과 메모리, 저장장치, 네트워크가 같은 버스 위에서 동등하게 놓이는 구조로 바꾸겠다고 말합니다.
그 버스의 이름이 유니파이드버스입니다. 하나의 공개 규약으로 CPU와 NPU, 메모리, SSD, 네트워크 카드, 스위치를 연결하며, 화웨이는 이 기술이 있어야 나머지 구조가 성립한다고 설명합니다.
이 구조로 만든 첫 제품이 아틀라스 950 슈퍼포드입니다. 어센드 950 가속기 1,024장을 담아 FP8 기준 1엑사플롭스를 내고, 256테라바이트 주소 공간을 공유하며, 내부에서 초당 16페타바이트를 주고받습니다.
캐비닛 160대가 왜 한 대로 취급되는지는 지연 시간이 설명합니다. 가속기 두 장 사이를 오가는 왕복 시간이 3마이크로초로 제시됐습니다. 약 1,000제곱미터에 흩어진 장비를 묶음이 아니라 기계 한 대로 프로그래밍할 수 있는 근거가 이 수치입니다.
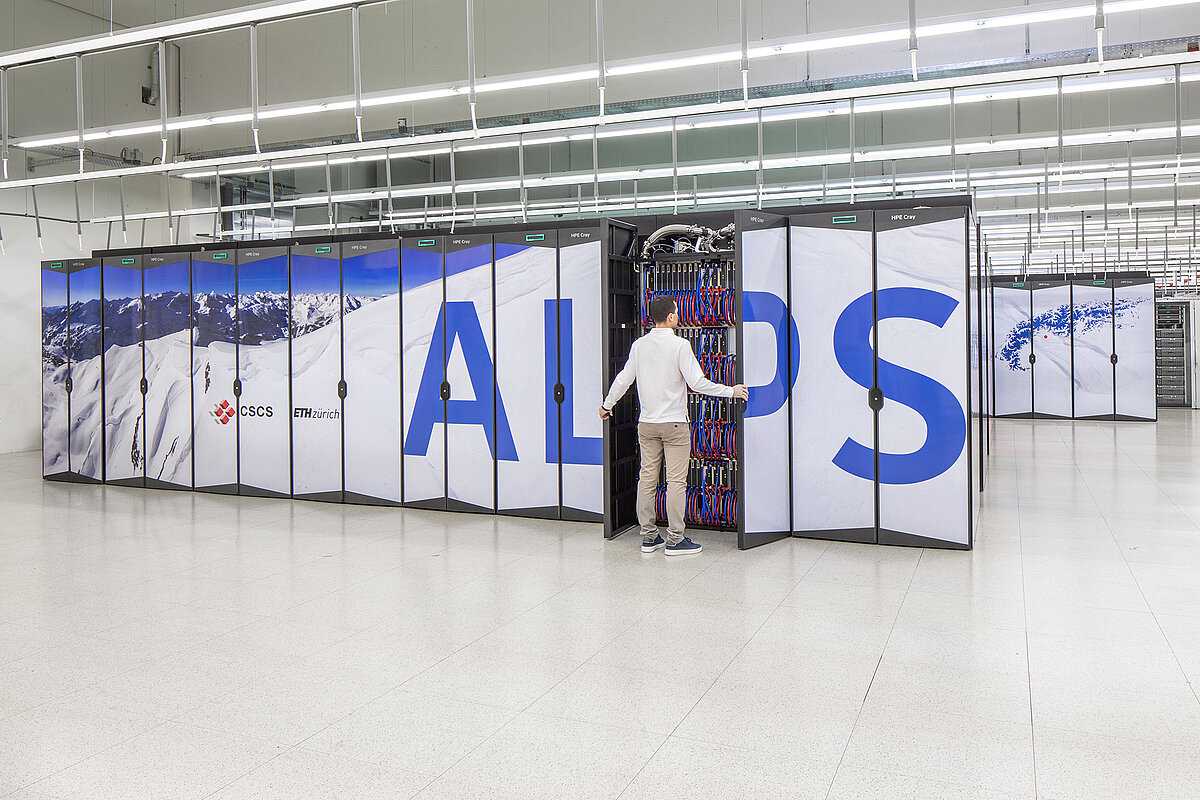
그 위 단계가 슈퍼클러스터입니다. 화웨이는 카드 25만 6천 장짜리 구성이 이미 설치되고 있다고 밝혔습니다. 근접 실장 광학을 쓰는 아틀라스 960 구성은 시험 중이라고 했습니다.
근접 실장 광학이 중요한 이유는 구리 배선이 먼저 한계에 닿기 때문입니다. 광 부품을 기판 가장자리가 아니라 칩 패키지 바로 옆으로 옮기는 방식이고, 화웨이는 9월 11일 초당 7.2테라비트 모듈을 같은 방향에서 공개했습니다. 노광 쪽에서 같은 압력을 다룬 글은 High-NA EUV가 웨이퍼 100만 장을 넘어선 이야기에 있습니다.
이 발표가 답하지 않은 것
가장 구체적인 의문은 숫자에서 나왔습니다. 중국 기술 분석가 루이 마는 화웨이가 예전에 아틀라스 960 슈퍼포드가 어센드 960 칩 1만 5,488장까지 늘어난다고 설명했는데, 이번 주 무대에 오른 구성은 4,096장이었다고 지적했습니다.
칩 자체는 훨씬 빨리 나오지만 함께 공개된 슈퍼포드는 원래 제시한 것보다 훨씬 작다는 것이 그의 평가입니다. 화웨이는 이 차이를 설명하지 않았습니다.
여기 나온 성능 수치는 모두 회사가 직접 낸 값이기도 합니다. 아틀라스 950 슈퍼포드를 외부 기관이 측정한 적은 없고, FP8과 FP4 엑사플롭스는 실제 모델을 돌려 얻은 처리량이 아니라 이론상 최대치입니다.

공급은 별개의 문제입니다. 트렌드포스는 9월 10일 중국 AI 칩 업체들이 HBM 원가 상승을 이유로 값을 올리고 있으며 950DT는 최대 50퍼센트까지 올랐다고 전했습니다. 메모리가 넉넉하지 않다는 신호입니다.
용도가 갈리는 구도도 아직 그대로입니다. 블룸버그는 중국의 주요 연구소들이 학습에는 여전히 엔비디아 하드웨어를 쓰고 자국 칩은 추론에서 자리를 넓히고 있다고 전했습니다. 로드맵이 주는 인상보다 좁은 성과입니다.
시점도 우연은 아닙니다. 이번 발표는 트럼프 대통령과 시진핑 주석이 9월 24일 워싱턴에서 만나기 일주일 전에 나왔습니다. 로드맵과 새 구조 모두 고객만을 향한 발표로는 읽히지 않습니다.
참고 자료
TechCrunch(Kate Park), “Huawei plans Q1 2027 launch of new AI chip as it takes on Nvidia”, 2026.9.17 / 화웨이 보도자료 “Huawei Pioneers a New Computing Architecture for the AI Era”, 2026.9.17 / TrendForce, 2026.9.17 및 2026.9.10 / 관찰자망·커촹반일보 보도, 2026.9.17 / 블룸버그, 2026.9.16.